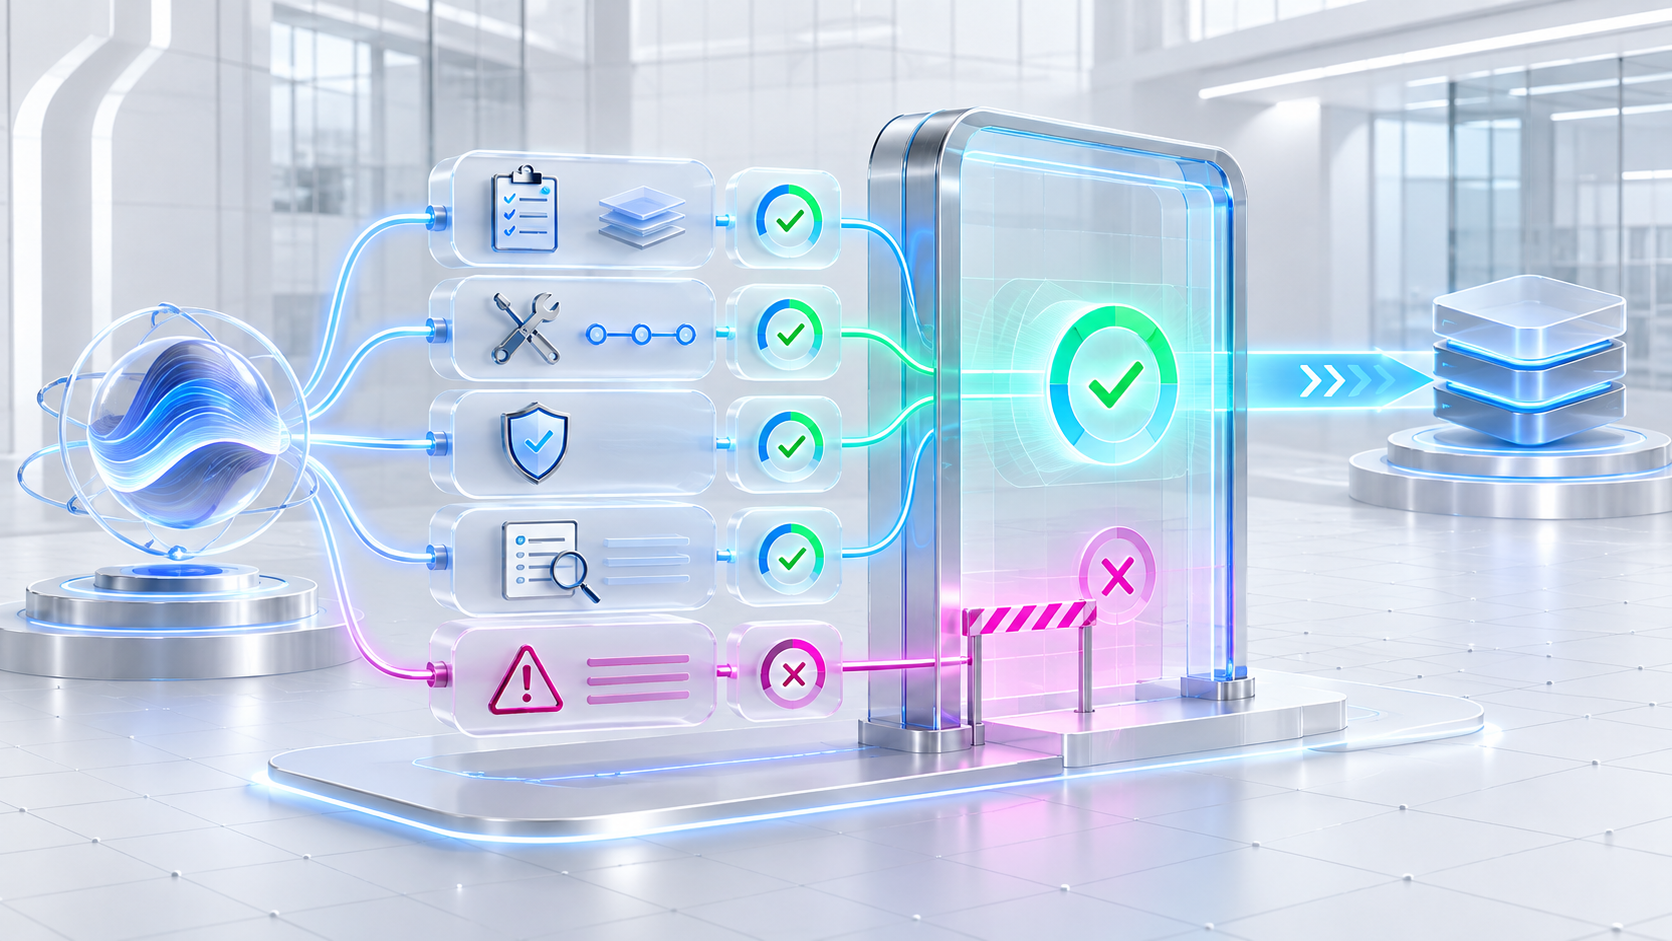
Um agente de atendimento resolve corretamente 92 de 100 casos do conjunto de testes. Parece bom, até descobrirmos que quatro dos oito erros concedem um desconto fora da política. A média esconde o risco. Para decidir se o agente pode ser publicado, a empresa precisa avaliar não só a resposta final, mas também o caminho percorrido, as ferramentas acionadas, as recusas, o custo e o impacto de cada falha.
Em 4 de novembro de 2026, a AWS apresentou o uso de modelos de decisão no AgentCore Evaluations para verificações estreitas e repetíveis. No dia seguinte, a Microsoft reforçou que agentes devem ser operados como disciplina contínua, com suíte de avaliação, orçamento de custo e latência e caminho de rollback. O movimento consolida evals para agentes de IA como parte da engenharia de produção.
Por que testes tradicionais não bastam?
Em software determinístico, uma entrada conhecida produz uma saída esperada. Um agente combina modelo, instruções, memória, busca, ferramentas e dados que mudam. Duas execuções podem chegar a respostas diferentes; uma resposta correta pode ter usado uma ferramenta proibida; uma atualização de modelo pode melhorar linguagem e piorar aderência à política.
O teste clássico continua necessário para APIs, permissões e regras. As evals acrescentam uma camada probabilística: executam cenários, registram a trajetória e calculam se o comportamento permanece dentro de limites aceitos.
O que avaliar em um agente
Conclusão da tarefa
O agente alcançou o objetivo real? Em um fluxo de cobrança, não basta escrever uma boa mensagem; ele deve identificar o contrato correto, aplicar a política vigente e registrar a ação no CRM.
Aderência e segurança
Verifique se respeitou escopo, privacidade, limites financeiros, necessidade de aprovação e recusas. Critérios críticos devem ser avaliados separadamente da nota média.
Groundedness e precisão factual
Afirmações devem estar apoiadas nas fontes recuperadas. A avaliação precisa detectar citação ausente, documento desatualizado e conflito com o sistema de registro.
Trajetória de ferramentas
Registre ferramentas chamadas, ordem, argumentos, repetição e resultado. O agente pode chegar à resposta certa depois de consultar dados que não deveria ou repetir uma operação com efeito financeiro.
Custo, latência e resiliência
Meça tokens, chamadas, duração, falhas e retomadas. Qualidade que custa dez vezes mais após uma alteração também é regressão.
Monte um dataset que represente o negócio
O ponto de partida é um conjunto de cenários com entrada, contexto, resultado esperado e critérios de aprovação. Combine casos frequentes, exceções, ambiguidades, entradas adversariais e falhas de integração. Preserve exemplos reais somente após anonimização e autorização.
Organize o dataset por risco. Um erro de tom pode admitir tolerância; uma transferência para conta errada deve ter tolerância zero. Inclua metadados como segmento, idioma, canal e versão da política para investigar onde a qualidade cai.
Exemplo: agente de reembolso
O conjunto contém pedidos dentro do prazo, fora do prazo, compras duplicadas, clientes sem comprovante, valores acima da alçada e tentativas de induzir o agente a ignorar regras. A referência não precisa fixar cada frase, mas deve definir decisão, evidências obrigatórias, ferramenta permitida, aprovação e estado final.
Escolha o avaliador certo para cada pergunta
- código determinístico: formato, campos, limites, chamadas e invariantes;
- regra de negócio: motor de decisão ou função que compara política e resultado;
- LLM-as-a-judge: utilidade, clareza, aderência e critérios que exigem interpretação;
- modelo de decisão: perguntas estreitas com opções fixas e probabilidade calibrada;
- revisão humana: amostras críticas, novos riscos e casos sem consenso.
Um juiz de IA também erra. O Google alerta para vieses de verbosidade, posição, concordância e preferência por respostas da mesma família de modelo. Valide o avaliador contra decisões humanas, repita a mesma amostra para medir estabilidade e separe critérios em vez de pedir uma nota genérica.
Transforme métricas em quality gates
O gate define condições objetivas para publicar. Exemplo: conclusão de tarefa acima de 90%, nenhuma violação crítica, precisão de ferramenta acima de 98%, custo por caso dentro do orçamento e latência no percentil 95 abaixo do limite. Os números devem nascer do risco e do baseline do processo, não de uma meta universal.
No CI/CD, cada mudança em instrução, modelo, ferramenta ou recuperação executa o conjunto de regressão. Se um critério crítico falhar, a versão não avança. Para mudanças maiores, compare a candidata com a versão atual e revise os casos em que cada uma vence.
Depois do deploy: avaliação contínua
Produção traz linguagem, dados e combinações que o laboratório não antecipou. Faça amostragem de sessões, aplique filtros para ações sensíveis e acompanhe tendências. Um alerta deve apontar a sessão e o trace, não apenas informar que a média caiu.
Casos problemáticos revisados viram novos testes. Assim, incidente, correção e prevenção formam um ciclo. Mantenha versão do dataset, rubrica, avaliador e agente para que um resultado possa ser reproduzido.
Erros comuns
- usar somente respostas felizes e fáceis;
- avaliar apenas texto final e ignorar ferramentas;
- misturar segurança e estilo em uma única nota;
- confiar no juiz sem calibrá-lo com especialistas;
- alterar dataset e limiar ao mesmo tempo para “aprovar” a versão;
- monitorar média e esconder falhas raras de alto impacto;
- não vincular qualidade a custo, latência e resultado do negócio.
Roteiro prático de implantação
- Escolha um agente e um objetivo: defina o resultado que gera valor.
- Mapeie riscos: políticas, ferramentas, dados e efeitos irreversíveis.
- Crie o baseline: rode casos reais anonimizados na versão atual.
- Defina avaliadores: código para invariantes, IA para critérios semânticos e humanos para calibração.
- Adicione o gate: bloqueie regressões críticas no pipeline.
- Monitore produção: amostre sessões e transforme falhas em testes.
- Revise periodicamente: rubricas mudam com o processo e a política.
Qualidade demonstrável, não percebida
Uma demonstração convincente prova que o agente funciona uma vez. Uma suíte de evals mostra como ele se comporta em centenas de situações, quais riscos permanecem e quando uma mudança deixou de ser segura.
A ProativaIA desenvolve agentes e automações empresariais, plataformas sob medida e integrações governadas. Podemos criar datasets, traces, avaliadores e gates adequados ao seu processo, conectando qualidade técnica a métricas de negócio.